
Transformers documentation
最適化
最適化
.optimization モジュールは以下を提供します:
- weight decayが固定されたオプティマイザーで、モデルのファインチューニングに使用でき、
_LRScheduleを継承するスケジュールオブジェクトの形式で、複数のスケジュール:- 複数のバッチの勾配を蓄積するための勾配蓄積クラス
AdaFactor
class transformers.Adafactor
< source >( paramslr = Noneeps = (1e-30, 0.001)clip_threshold = 1.0decay_rate = -0.8beta1 = Noneweight_decay = 0.0scale_parameter = Truerelative_step = Truewarmup_init = False )
パラメータ
- params (
Iterable[nn.parameter.Parameter]) — 最適化対象のパラメータのイテラブル、またはパラメータグループを定義する辞書。 - lr (
float, 省略可) — 外部学習率です。 - eps (
tuple[float, float]、任意、デフォルトは(1e-30, 0.001)) — それぞれ、勾配の二乗とパラメータのスケーリング用の正則化定数です。 - clip_threshold (
float、任意、デフォルト値は 1.0) — 最終的な勾配更新の二乗平均平方根(RMS)の閾値 - decay_rate (
float、任意、デフォルト値は -0.8) — 二乗の移動平均を計算するために使用される係数 - beta1 (
float, 任意) — 勾配の移動平均を計算するために使用される係数 - weight_decay (
float、任意、デフォルト値は 0.0) — 重み減衰(L2 正則化) - scale_parameter (
bool、任意、デフォルトはTrue) — True の場合、学習率は均方根によってスケーリングされます - relative_step (
bool、省略可、デフォルトはTrue) — True の場合、外部の学習率ではなく、時間依存の学習率が計算されます。 - warmup_init (
bool、任意、デフォルトはFalse) — 時間依存の学習率の計算は、ウォームアップ初期化が使用されているかどうかによって異なります
AdaFactorのPyTorch実装は、Adamの置き換えとしてそのまま使用できます。元のfairseqコード: https://github.com/pytorch/fairseq/blob/master/fairseq/optim/adafactor.py
論文: Adafactor: Adaptive Learning Rates with Sublinear Memory Cost https://huggingface.co/papers/1804.04235 このオプティマイザーは、scale_parameter、relative_step、warmup_init のオプションに応じて、内部で学習率を調整します。手動(外部)の学習率スケジュールを使用する場合は、scale_parameter=False および relative_step=False を設定してください。
この実装は低精度(FP16、bfloat)の値を処理しますが、徹底的なテストは行われていません。
推奨されるT5のファインチューニング設定(https://discuss.huggingface.co/t/t5-finetuning-tips/684/3):
LR warmupやclip_thresholdなしでのトレーニングは推奨されません。
- スケジュールされたLRウォームアップを固定LRに変更
- clip_threshold=1.0 を使用します(https://huggingface.co/papers/1804.04235)
相対的な更新を無効にする
scale_parameter=False を使用します
勾配クリッピングなどの追加のオプティマイザー操作は、Adafactor と併用しないでください。
例:
Adafactor(model.parameters(), scale_parameter=False, relative_step=False, warmup_init=False, lr=1e-3)他のユーザーは、以下の組み合わせがうまく機能すると報告しています。
Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)lr=None を Trainer と一緒に使用する場合は、AdafactorSchedule を使用する必要がある可能性が高いです。
以下のようにスケジューラを設定します:
from transformers.optimization import Adafactor, AdafactorSchedule

optimizer = Adafactor(model.parameters(), scale_parameter=True, relative_step=True, warmup_init=True, lr=None)
lr_scheduler = AdafactorSchedule(optimizer)
trainer = Trainer(..., optimizers=(optimizer, lr_scheduler))
使用方法:
# replace AdamW with Adafactor
optimizer = Adafactor(
    model.parameters(),
    lr=1e-3,
    eps=(1e-30, 1e-3),
    clip_threshold=1.0,
    decay_rate=-0.8,
    beta1=None,
    weight_decay=0.0,
    relative_step=False,
    scale_parameter=False,
    warmup_init=False,
)1回の最適化ステップを実行します
スケジュール
SchedulerType
クラス transformers.SchedulerType
< source >( valuenames = Nonemodule = Nonequalname = Nonetype = Nonestart = 1boundary = None )
TrainingArgumentsのパラメータlr_scheduler_typeに指定するスケジューラー名。
デフォルトでは“linear”を使用します。内部では、Trainerからget_linear_schedule_with_warmupスケジューラーを取得します。
スケジューラーの種類:
- “linear” = get_linear_schedule_with_warmup()
- “cosine” = get_cosine_schedule_with_warmup()
- “cosine_with_restarts” = get_cosine_with_hard_restarts_schedule_with_warmup()
- “polynomial” = get_polynomial_decay_schedule_with_warmup()
- “constant” = get_constant_schedule()
- “constant_with_warmup” = get_constant_schedule_with_warmup()
- “inverse_sqrt” = get_inverse_sqrt_schedule()
- “reduce_lr_on_plateau” = get_reduce_on_plateau_schedule()
- “cosine_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup()
- “cosine_warmup_with_min_lr” = get_cosine_with_min_lr_schedule_with_warmup_lr_rate()
- “warmup_stable_decay” = get_wsd_schedule()
- “greedy” = get_greedy_schedule()
get_scheduler
transformers.get_scheduler
< source >( name: str | SchedulerTypeoptimizer: Optimizernum_warmup_steps: int | None = Nonenum_training_steps: int | None = Nonescheduler_specific_kwargs: dict | None = None )
パラメータ
- name (
strまたはSchedulerType) — 使用するスケジューラーの名前。 - optimizer (
torch.optim.Optimizer) — 学習中に使用されるオプティマイザー。 - num_warmup_steps (
int, 任意) — ウォームアップステップの回数です。すべてのスケジューラでこの引数は必須ではありません(そのため引数は任意です)。この値が設定されておらず、スケジューラの種類がそれを要求する場合、関数はエラーを発生させます。 - num_training_steps (`int“, 任意) — 実行するトレーニングステップの数です。すべてのスケジューラーでこの引数は必須ではありません(そのため引数は任意です)。この値が設定されておらず、スケジューラーの種類がそれを要求する場合、関数はエラーを発生させます。
- scheduler_specific_kwargs (
dict, 任意) — cosine with restarts などのスケジューラ用の追加パラメータです。スケジューラの種類とスケジューラのパラメータが一致しない場合、スケジューラ関数から TypeError が発生します。
Unified API を使用して、名前から任意のスケジューラーを取得します。
get_constant_schedule
transformers.get_constant_schedule
< source >( optimizer: Optimizerlast_epoch: int = -1 )
optimizerで設定された学習率を使用して、一定の学習率でスケジュールを作成します。
get_constant_schedule_with_warmup
transformers.get_constant_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intlast_epoch: int = -1 )
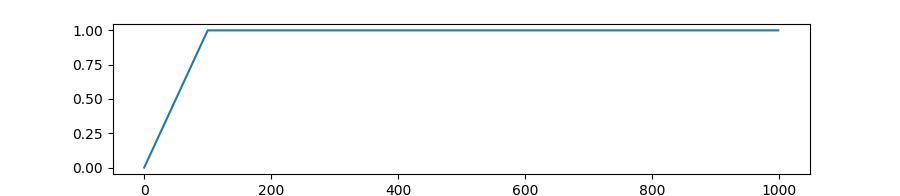
0からオプティマイザーで設定された初期lrまで線形に増加するウォームアップ期間に続き、一定の学習率でスケジュールを作成します。
get_cosine_schedule_with_warmup
transformers.get_cosine_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1 )
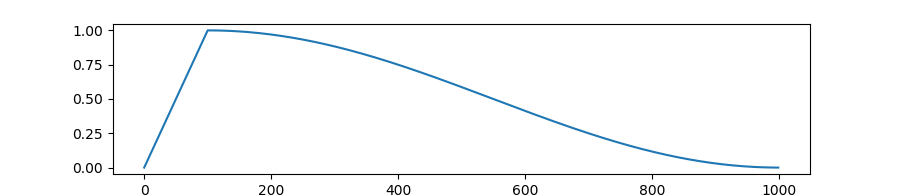
optimizerで設定された初期lrから0へ、コサイン関数の値に従って減少する学習率のスケジュールを作成します。この際、0からoptimizerで設定された初期lrまで線形に増加するウォームアップ期間を設けます。
get_cosine_with_hard_restarts_schedule_with_warmup
transformers.get_cosine_with_hard_restarts_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: int = 1last_epoch: int = -1 )
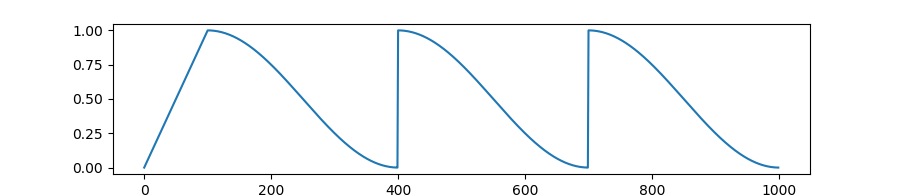
optimizerで設定された初期lrから0までの値を、コサイン関数の値に従って減少させるスケジュールを作成します。このスケジュールには、0からoptimizerで設定された初期lrまで線形に増加するウォームアップ期間の後に、複数のハードリスタートが含まれます。
get_cosine_with_min_lr_schedule_with_warmup
transformers.get_cosine_with_min_lr_schedule_with_warmup
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = None )
パラメータ
- optimizer (
~torch.optim.Optimizer) — 学習率のスケジュールを設定するオプティマイザー。 - num_warmup_steps (
int) — ウォームアップフェーズのステップ数です。 - num_training_steps (
int) — 学習ステップの総数。 - num_cycles (
float、任意、デフォルト値は 0.5) — コサインスケジュールにおける波の数です(デフォルトでは、半コサインに従って最大値から 0 へ減少します)。 - last_epoch (
int、任意、デフォルトは -1) — 学習を再開する際の最後のエポックのインデックス。 - min_lr (
float, 省略可) — コサインスケジュールの終了後に到達する最小学習率です。 - min_lr_rate (
float、任意) — 初期学習率に対する最小学習率の比率です。設定した場合、min_lrは設定しないでください。
optimizerで設定された初期lrからmin_lrまで、コサイン関数の値に従って減少する学習率のスケジュールを作成します。この際、ウォームアップ期間中は0からoptimizerで設定された初期lrまで線形に増加します。
get_cosine_with_min_lr_schedule_with_warmup_lr_rate
transformers.get_cosine_with_min_lr_schedule_with_warmup_lr_rate
< source >( optimizer: Optimizernum_warmup_steps: intnum_training_steps: intnum_cycles: float = 0.5last_epoch: int = -1min_lr: float | None = Nonemin_lr_rate: float | None = Nonewarmup_lr_rate: float | None = None )
パラメータ
- optimizer (
~torch.optim.Optimizer) — 学習率のスケジュールを設定するオプティマイザー。 - num_warmup_steps (
int) — ウォームアップフェーズのステップ数です。 - num_training_steps (
int) — 学習ステップの総数。 - num_cycles (
float、任意、デフォルト値は 0.5) — コサインスケジュールにおける波の数です(デフォルトでは、半コサインに従って最大値から 0 へ減少します)。 - last_epoch (
int、任意、デフォルトは -1) — 学習を再開する際の最後のエポックのインデックス。 - min_lr (
float, 省略可) — コサインスケジュールの終了後に到達する最小学習率です。 - min_lr_rate (
float、任意) — 初期学習率に対する最小学習率の比率です。設定した場合、min_lrは設定しないでください。 - warmup_lr_rate (
float, 任意) — 開始学習率に対する最小学習率の比率です。設定されていない場合、warmup_lr_rateは float(1/num_warmup_steps) として扱われます。
optimizerで設定された初期lrからmin_lrまで、コサイン関数の値に従って減少する学習率のスケジュールを作成します。この際、ウォームアップ期間中は0からoptimizerで設定された初期lrまで線形に増加します。
GreedyLR
class transformers.GreedyLR
< source >( optimizer: Optimizermode: str = 'min'factor: float = 0.95patience: int = 10threshold: float = 1e-06threshold_mode: str = 'abs'cooldown: int = 0warmup: int = 0min_lr: float | list[float] = 0.001max_lr: float | list[float] = 1.0eps: float = 1e-08verbose: bool = Falsesmooth: bool = Falsewindow_size: int = 50reset_start: int = 500 )
パラメータ
- optimizer (
~torch.optim.Optimizer) — 学習率のスケジュールを設定するオプティマイザー。 - mode (
str、任意、デフォルトは"min") — ‘min’ または ‘max’ のいずれかです。‘min’ モードでは、メトリックの減少が止まったときに LR が減少し、‘max’ モードでは増加が止まったときに減少します。 - factor (
float, 任意、デフォルト値は 0.95) — 学習率を調整するための係数です。プラトー(停滞)時に学習率は factor を乗算され、改善時には factor で除算されます。1.0 未満である必要があります。 - patience (
int、省略可、デフォルトは 10) — 学習率が調整されるまでの、改善が見られないエポック数。 - threshold (
float、任意、デフォルト値: 1e-06) — 新しい最適解を測定するための閾値。 - threshold_mode (
str、任意、デフォルトは"abs") — ‘rel’ または ‘abs’ のいずれかです。 - cooldown (
int、任意、デフォルトは 0) — LR が削減された後、通常の動作を再開するまで待機するエポック数。 - warmup (
int、任意、デフォルトは 0)— LR が増加した後に通常の動作を再開するまで待機するエポック数。 - min_lr (
floatまたはlist[float]、任意、デフォルト値は 0.001) — 学習率の下限値です。 - max_lr (
floatまたはlist[float]、任意、デフォルト値は 1.0) — 学習率の上限値です。 - eps (
float、任意、デフォルト値は 1e-08) — lr に適用される最小の減衰量。 - verbose (
bool、任意、デフォルトはFalse) — True の場合、各更新ごとにメッセージを標準出力に出力します。 - smooth (
bool、任意、デフォルトはFalse) — True の場合、メトリクスにストリーミング平均スムージングを適用します。 - window_size (
int, 任意, デフォルトは 50) — smooth=True の場合のストリーミング平均のウィンドウサイズです。 - reset_start (
int、任意、デフォルト値は 500)— 初期状態にリセットする前に min_lr で待機するステップ数。
学習メトリクスに応じて反応する適応型学習率スケジューラ。
GreedyLR は、トレーニングの性能に基づいて学習率を動的に調整します:
- メトリクスが一貫して改善した場合にLRを増加させます(係数で割る)
- メトリクスが頭打ちになるとLRを減少させます(係数を乗算)
これは、コサインアニーリングのような従来のスケジューラーとは異なり、事前に決められたスケジュールに従うのではなく、実際のトレーニングの動向に応じて学習率を調整します。
参考文献: GreedyLR: A Novel Adaptive Learning Rate Scheduler <https://arxiv.org/abs/2512.14527>_
例:
>>> optimizer = torch.optim.SGD(model.parameters(), lr=0.1)
>>> scheduler = GreedyLR(optimizer, mode="min", patience=10)
>>> for epoch in range(100):
...     train(...)
...     val_loss = validate(...)
... scheduler.step(val_loss)現在のスケジューラーによって最後に計算された学習率を返します。
辞書から状態を読み込みます。
スケジューラーの状態を辞書として返します。
ステップ
< source >( metrics: floatepoch: int | None = None )
与えられたメトリクスに基づいてスケジューラーのステップを実行します。
get_greedy_schedule
transformers.get_greedy_schedule
< source >( optimizer: Optimizer**kwargs )
パラメータ
- optimizer (
~torch.optim.Optimizer) — 学習率のスケジュールを設定するオプティマイザー。 - kwargs (
dict、任意) — スケジューラに渡す追加のパラメータ。使用可能なパラメータについては、GreedyLRを参照してください。
学習指標に基づいて学習率を調整する適応型学習率スケジューラを作成します。
get_linear_schedule_with_warmup
transformers.get_linear_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslast_epoch = -1 )
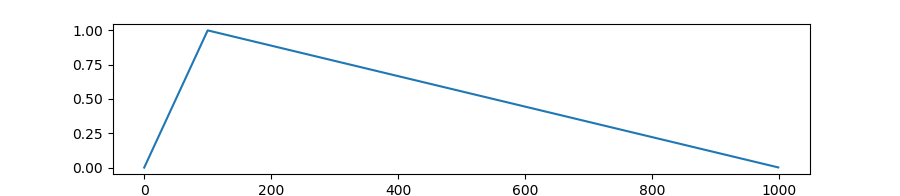
オプティマイザーで設定された初期lrから0へ線形に減少する学習率のスケジュールを作成します。この際、0からオプティマイザーで設定された初期lrへ線形に増加するウォームアップ期間を設けます。
get_polynomial_decay_schedule_with_warmup
transformers.get_polynomial_decay_schedule_with_warmup
< source >( optimizernum_warmup_stepsnum_training_stepslr_end = 1e-07power = 1.0last_epoch = -1 )
オプティマイザーに設定された初期学習率から、lr_endで定義される終了学習率まで、多項式減衰によって減少するスケジュールを作成します。この際、ウォームアップ期間中は、オプティマイザーに設定された初期学習率まで0から線形に増加します。
注: powerは、fairseqの実装と同様にデフォルトで1.0です。fairseqの実装は、https://github.com/google-research/bert/blob/f39e881b169b9d53bea03d2d341b31707a6c052b/optimization.py#L37にあるBERTのオリジナル実装に基づいています。
get_inverse_sqrt_schedule
transformers.get_inverse_sqrt_schedule
< source >( optimizer: Optimizernum_warmup_steps: inttimescale: int | None = Nonelast_epoch: int = -1 )
オプティマイザーで設定された初期lrから、lrを0から初期lrまで線形に増加させるウォームアップ期間の後に、逆平方根の学習率スケジュールを作成します。
get_reduce_on_plateau_schedule
transformers.get_reduce_on_plateau_schedule
< source >( optimizer: Optimizer**kwargs )
指標の改善が止まったときに減少する、一定の学習率を持つスケジュールを作成します。
get_wsd_schedule
transformers.get_wsd_schedule
< source >( optimizer: Optimizernum_warmup_steps: intnum_decay_steps: intnum_training_steps: int | None = Nonenum_stable_steps: int | None = Nonewarmup_type: str = 'linear'decay_type: str = 'cosine'min_lr_ratio: float = 0num_cycles: float = 0.5last_epoch: int = -1 )
パラメータ
- optimizer (
~torch.optim.Optimizer) — 学習率のスケジュールを設定するオプティマイザー。 - num_warmup_steps (
int) — ウォームアップフェーズのステップ数です。 - num_decay_steps (
int) — 減衰フェーズのステップ数。 - num_training_steps (
int、任意) — トレーニングステップの総数です。これは、ウォームアップ、安定、減衰のステップ数の合計です。num_stable_stepsが指定されていない場合、安定フェーズはnum_training_steps - num_warmup_steps - num_decay_stepsになります。 - num_stable_steps (
int, 任意) — 安定フェーズのステップ数。num_warmup_steps + num_stable_steps + num_decay_stepsがnum_training_stepsと等しくなるようにしてください。等しくない場合、その他のステップは最小学習率がデフォルトとして使用されます。 - warmup_type (
str, 任意、デフォルトは “linear”) — 使用するウォームアップの種類です。‘linear’、‘cosine’、‘1-sqrt’ のいずれかを指定できます。 - decay_type (
str, 任意、デフォルトは “cosine”) — 使用する減衰の種類です。‘linear’、‘cosine’、‘1-sqrt’ のいずれかを指定できます。 - min_lr_ratio (
float、任意、デフォルト値は 0)— 初期学習率に対する最小学習率の比率。 - num_cycles (
float、任意、デフォルト値は 0.5) — コサインスケジュールにおける波の数です(デフォルトでは、半コサインに従って最大値から 0 へ減少します)。 - last_epoch (
int、任意、デフォルトは -1) — 学習を再開する際の最後のエポックのインデックス。
3段階の学習率を持つスケジュールを作成します:
- warmup: warmup_type に従い、初期学習率の min_lr_ratio 倍から初期学習率まで段階的に増加させます。
- stable: 一定の学習率。
- decay: 初期学習率から、decay_typeに従って初期学習率のmin_lr_ratio倍まで減少します。